结论先行:过去十年时间序列预测模型的设计史,可以重写成一部“押注竞赛”——每个方法都在押不同的数据结构假设:什么该成为一个 token、attention 该花在哪个轴上、要不要显式分解趋势、未来该一步步生成还是整窗输出。scaling 是选择环境:跨域预训练之后,trend 分解、频域基、严格 channel independence 这些强领域偏置大多被淘汰,patch、归一化、参数共享这些弱而通用的偏置活了下来。归纳偏置这个视角的全部用处,是逼你回答五个问题:假设了什么、针对哪个瓶颈、何时失效、能否让数据去学、放大后还值不值得保留。
引子:有限数据 + 归纳偏置 → 泛化
为什么一个只见过有限训练点的模型,能在没见过的点上做对预测?因为数据本身给不出答案:与训练数据完全一致的函数有无穷多个,它们在训练范围外彼此分歧。要让学习发生,学习器必须对“哪些解更合理”有一个系统性的偏好——这就是归纳偏置:
$$\text{有限数据} + \text{归纳偏置} \rightarrow \text{泛化}$$No Free Lunch 定理给了它一个反面表述:如果对所有可能任务一视同仁,就不存在在任何任务上都更优的算法。现实学习之所以可能,是因为真实世界不是任意的,它有结构,而模型必须押注这些结构。
先澄清一个容易混淆的点。教科书(比如李航《统计学习方法》)给人的印象是归纳偏置≈假设空间,但它只是偏置的一部分:架构、损失函数、正则、优化器、参数共享、tokenization、归一化、数据增强、预测形式,甚至搜索与决策过程,每一处都在注入偏好。它贯穿学习流程的每个环节。
另外,这里的 bias 不是统计学里“估计有偏差”的那个 bias,它更接近 preference / prior / tendency:面对多个可能解时不保持中立,而是系统性偏向其中一部分。
下面这张图是整场讨论的全景框架,本文按其中第 5 到第 10 块展开:
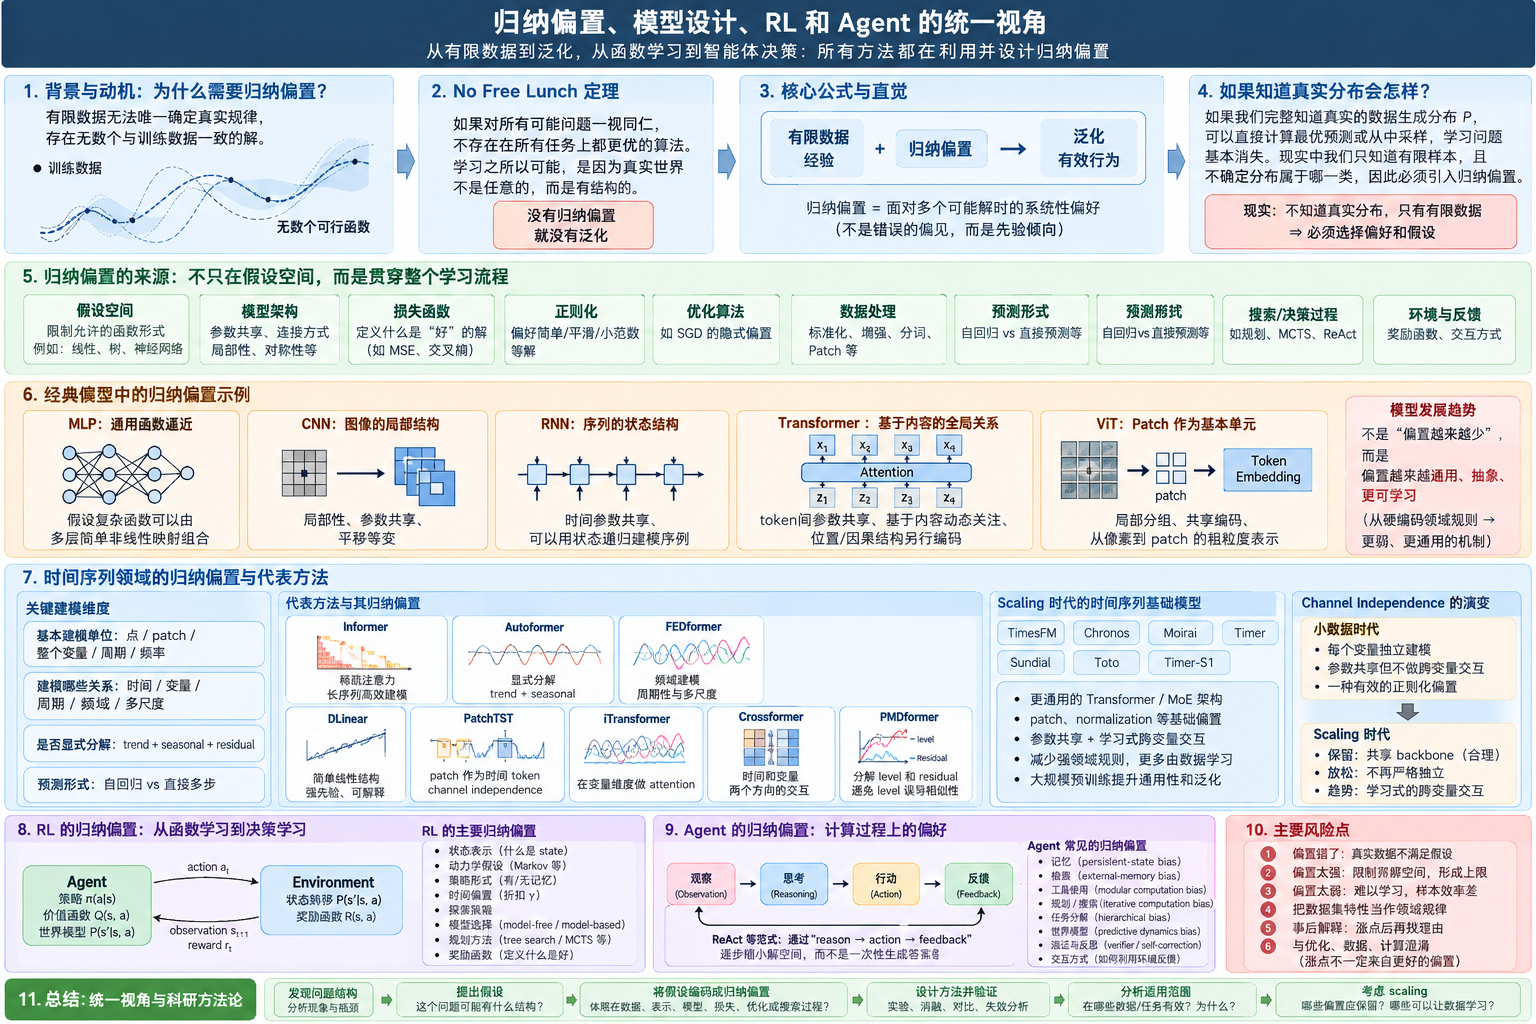
模型演进:每个模型押了什么,买到什么,付出什么
用“它预先假定了什么结构”重读经典模型,会发现每个架构本质上是一笔押注:拿一个假设换样本效率,同时付出另一种能力作为代价。下图是五个模型的完整对照和 ViT patch 的拆解,正文只提炼主线。
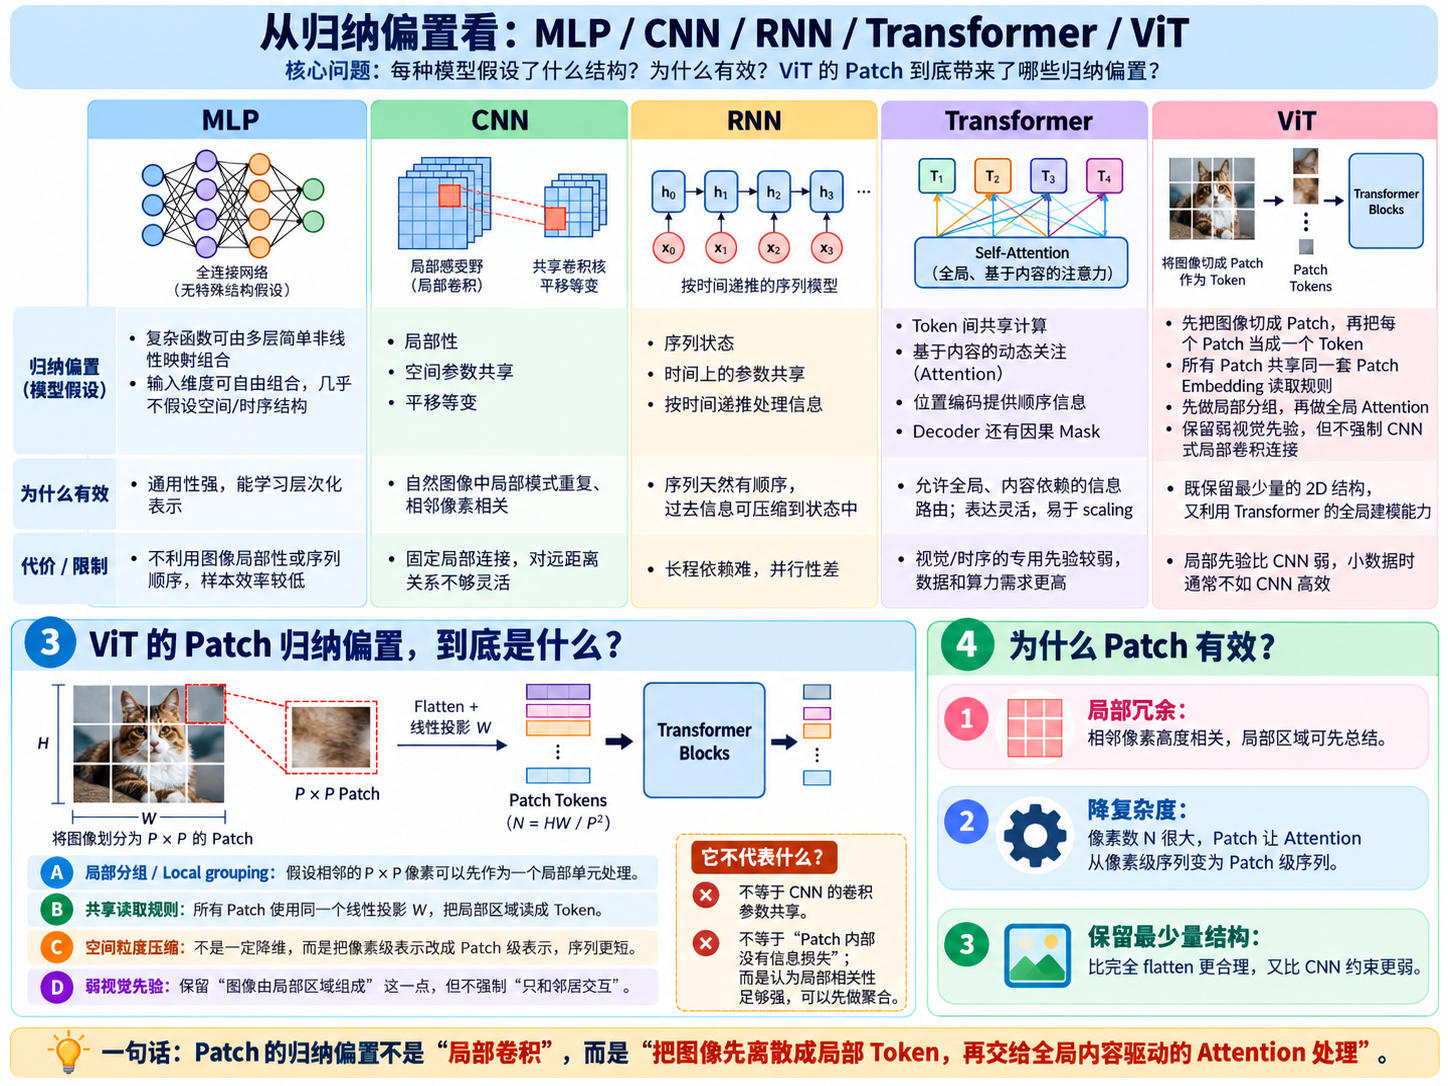
五个模型的押注
| 模型 | 押了什么(归纳偏置) | 买到什么 | 付出什么 |
|---|---|---|---|
| MLP | 复杂函数可由多层简单非线性映射组合;不假设输入有空间或时序结构 | 通用性强,能学习层次化表示 | 不利用任何数据结构,样本效率低 |
| CNN | 局部性、空间参数共享、平移等变 | 契合自然图像局部模式重复、相邻像素相关的分布 | 固定局部连接,对远距离关系不够灵活 |
| RNN | 信息可递归压缩进状态、时间上参数共享 | 契合序列天然有顺序,过去信息可压进固定状态 | 长程依赖难,并行性差 |
| Transformer | token 间共享计算、基于内容动态决定关注谁、位置与因果另行编码 | 全局的、内容依赖的信息路由;表达灵活,易于 scaling | 视觉/时序专用先验弱,数据和算力需求更高 |
| ViT | 把图像先离散成局部 token,再交给全局内容驱动的 attention | 保留最少量 2D 结构,同时吃到 Transformer 的全局建模 | 局部先验弱于 CNN,小数据上不如 CNN 高效 |
这张表里有一个可读出的规律:越往下,假设越弱、越通用,对数据的要求越高。MLP 什么结构假设都不写;CNN 把“局部 + 共享”写死在架构里;Transformer 的合同里只写“token 间共享计算”这一条,其余留给数据说话。于是得到第一个判断:模型的发展不是“偏置越来越少”,而是偏置越来越通用、越来越抽象、越来越可学习。这个判断马上会在时间序列领域得到一次干净的检验。
ViT:patch 到底是什么偏置
ViT 是这个判断最具体的样本,也最容易被读错。流程很简单:把 $H \times W$ 的图像切成 $N = HW/P^2$ 个 $P \times P$ patch,每个 patch 展平后过同一个线性投影变成 token,送进标准 Transformer block。偏置藏在“切 patch”这一步里,可以拆成四个彼此独立的成分:
- 局部分组:相邻的 $P \times P$ 像素先当作一个单元处理——假设局部像素的相关性强到值得先聚合。
- 共享读取规则:所有 patch 用同一个线性投影 $W$——这才是卷积参数共享真正的传人。
- 粒度压缩:把建模单位从像素级换成 patch 级,序列短 $P^2$ 倍,attention 才花得起。
- 弱视觉先验:只保留“图像由局部区域组成”这一条常识,不强制“只能和邻居交互”。
两个常见误读,恰好对应第三、四件事必须拆开。patch 不等于 CNN 的卷积参数共享:分组发生在 attention 之前,进入 attention 层后每个 patch 都能看所有 patch。patch 也不等于“patch 内部没有信息损失”:$16 \times 16$ 个像素压成一个向量必然丢细节,它的合法性来自一个统计判断——局部相关性强,丢掉的部分不重要。一句话:patch 的归纳偏置不是“局部卷积”,而是“把图像先离散成局部 token,再交给全局内容驱动的 attention 处理”。
这个弱先验为什么反而有效?三个理由:局部冗余让分组成为几乎免费的压缩;attention 复杂度从像素级序列降到 patch 级序列,计算上可行;相比完全 flatten 保留了最少的 2D 结构,相比 CNN 又没有限制全局交互。代价同样清楚——数据不足时弱先验补不回样本效率,ViT 明显不如 CNN 高效。保留多少先验,从来是数据量和任务结构之间的平衡问题。
“局部分组不等于局部交互”这个区分,后面讲时间序列的 patch 时会原样复用。
时间序列:每个方法到底在押什么
长期时间序列预测(LTSF)过去几年是“模块军备竞赛”最激烈的领域,也是归纳偏置视角最好用的领域。换个问法,从“这个模型用了什么模块”改成“这个模型押了什么结构”,论文之间的真实分歧立刻显形。时序模型的押注集中在四个轴上:
- 基本建模单位(tokenization 偏置):单时间点、patch、整个变量轨迹、周期、频率成分。
- 哪些关系值得显式建模:时间、变量、周期、频域、多尺度。
- 是否显式分解结构:$x = \text{trend} + \text{seasonal} + \text{residual}$。
- 预测形式:自回归逐步生成,还是 direct multi-horizon 整窗输出。
把代表方法放进这张表:
| 方法 | 押的结构假设 | 针对的瓶颈 |
|---|---|---|
| Informer | attention 稀疏,少数主导 query 决定输出 | 长序列 $O(L^2)$ 注意力开销 |
| Autoformer | 序列可加性分解为趋势 + 季节 | 非平稳漂移难以直接建模 |
| FEDformer | 信息集中在低频成分 | 分解与注意力的双重开销 |
| DLinear | 时间模式足够简单,线性可分 | 复杂模型在弱信号上过拟合 |
| PatchTST | 局部时间片段比单点更适合做 token;变量共享参数但不必交互 | 单点 token 噪声大、语义不足 |
| iTransformer | 变量间关系比时间点间关系更值得显式建模 | 时间 attention 稀释了跨变量信息 |
| Crossformer / GridTST | 时间和变量两个轴都不可放弃 | 单轴建模各有盲区 |
什么该成为一个 token
早期时序 Transformer 里,一个 token 就是一个时间点(内含该时刻所有变量的观测),attention 建模的是 $t_i \leftrightarrow t_j$;PatchTST 把一小段连续时间压成一个 token,attention 建模 patch 之间的关系;iTransformer 干脆把一个变量的整段历史做成 token,attention 建模 $c_i \leftrightarrow c_j$,也就是变量之间的关系。
这三家用的其实是同一套注意力机制,真正的分歧是一个资源问题:attention 这份昂贵的预算,应该花在哪个轴上? PatchTST 花在时间上,iTransformer 花在变量上,Crossformer 两头都花。论文之争,本质是数据生成假设之争:这个领域的序列,到底是时间结构更值钱,还是变量结构更值钱。
预测形式本身也是偏置
自回归逐步生成看起来最“符合物理”,但它有三个隐藏代价:训练用真值、推理用预测值带来的 exposure bias;误差沿 rollout 累积;非线性系统里单步最优不等于多步最优。direct multi-horizon(一次输出整个未来窗口)绕开了这三点,代价是丢掉步间的联合结构。所以 direct 押的是:步间联合结构,不值那三笔代价的价——而且后面会看到,这个押注在 scaling 时代也被重新调整过。
归一化:从优化技巧到被审计的偏置
z-score 常被顺口说成“把序列变成标准正态”,这笔账要算清:线性变换改变不了分布形状,它实际做的事是三件——改善优化 conditioning、避免单位尺度支配模型,外加时序场景特有的第三条,默认把 level / scale 漂移当成 nuisance factor。前两条是优化技巧,第三条已经是领域偏置。
这个偏置最近正在被审计。TimeBridge(ICML 2025)的核心观点是:短期建模里,非平稳性会制造 spurious regression,应该部分消除;但长期建模里,非平稳性本身可能携带跨变量的协整关系(比如两只股票价格各自漂移、价差却稳定),全部平稳化等于把这个信号也删了。问题从“平稳化有没有利”升级成“哪些非平稳成分是 nuisance、哪些是 signal”——这正是对 bias 失效边界的直接研究。
scaling 时代:选择压登场
上一节的框架还是静态分类。真正有区分度的问题是:当参数、数据、上下文同时放大几个数量级,并且跨领域预训练时,哪些偏置还成立?2024 年之后兴起的时间序列基础模型(TSFM)逐个给出了答案。
| 模型 | 保留的偏置 | 放弃的偏置 |
|---|---|---|
| TimesFM | patch token、decoder-only、per-series 归一化 | trend 分解、频域基、手工周期模块 |
| Chronos | 把值量化成离散 token(押“序列近似一门语言”) | 原版押逐点自回归;Chronos-Bolt 换成 patch 输入 + 直接输出多步分位数,连自回归这个偏置也扔了 |
| Moirai | 共享 backbone、可学习的跨变量交互、任意频率与变量数 | 固定频率、固定变量数的领域设定 |
| Sundial | 原生 next-token 生成建模、patch | 确定性回归头 |
| Toto 2.0 | patch、归一化、参数共享、通用 Transformer + MoE | 一切手工领域规则 |
| Timer-S1 | patch、稀疏 MoE(8.3B 总参 / 每 token 激活 0.75B)、11.5K 上下文 | 标准 next-token 自回归与纯并行 direct 预测,换成 Serial-Token Prediction |
淘汰名单:显式 trend/seasonal 分解、Fourier 基、自相关算子、手工周期模块、严格 channel independence。存活名单:patch(粗粒化)、归一化、参数共享、可学习的跨变量交互。
scaling 证据里最干净的是 Toto 2.0:同一套训练 recipe,从 4M 到 2.5B 五个尺寸,每一档都比下一档好——这是时序领域少见的单调 scaling 曲线;而且它预训练只用 Datadog 内部可观测性指标和合成数据,完全不碰公开 benchmark,仍然在通用基准 GIFT-Eval 和专门防数据污染的 TIME 基准上排到第一。Chronos 和 Toto 的论文里也都给出对比:zero-shot 的基础模型在多个数据集上已经追平甚至超过“在目标数据集上专门训练”的小模型。Timer-S1 用约一万亿时间点的 TimeBench 语料训练,拿下 GIFT-Eval 预训练赛道最好的 MASE/CRPS。
为什么活下来的是这几个
存活标准只有一条:这个假设放到别的领域的数据上是否仍然成立。
patch 活下来,因为它押的东西便宜:任何领域、任何相邻采样点,局部相关都接近物理性质;它换来的又几乎全是计算收益——压缩序列长度、保留局部结构,同时不把任何解排除在假设空间之外。一条怎么押都输不大的注,scaling 自然带得走。归一化活下来,因为“level 和 scale 是 nuisance”在跨域数据上几乎总是对的——不同领域的序列,数值尺度千差万别,形状与动态才是共性。参数共享活下来,因为它就是“从数据学规律”的最一般形式。
反过来看被淘汰的那些:trend + seasonal 分解假设每条序列都有稳定的加性结构,电力和交通数据成立,金融价格未必;频域低秩假设信息集中在低频;严格 channel independence 假设跨变量信号弱——这在 ETT 这类 benchmark 上可能恰好成立(ETTh2 本身接近随机游走、跨变量依赖很弱),但没有任何理由相信它是所有时间序列的规律。被淘汰者只有一个共同点:假设只在特定 regime 成立——这就是 scaling 的淘汰标准,与复杂性多少无关。
Channel independence 的演变:一个绝佳的微观样本
PatchTST 的 channel independence 其实包着两层不同的偏置:一是所有变量共享同一套参数 $f_\theta$,二是变量之间不做信息交互。scaling 时代,前者被完整保留下来——所有 TSFM 都是共享 backbone;后者被普遍放宽——Moirai、Toto、TimeBridge 们把跨变量交互做成了可学习的组件。
结论可以压成一句:参数共享是普适偏置,严格独立只是小数据、弱跨变量信号 regime 下的 regularization 偏置。 把这两件常被混在一起的事拆开,正是偏置视角带来判断力的地方。
归纳偏置视角的作用,以及它什么时候骗你
用法:强迫每个方法回答五个问题
- 这个方法假设了什么?
- 这个假设针对哪个具体瓶颈?
- 它应该在什么数据上失效?
- 这个偏置必须写死,还是可以让数据去学?
- scale 变大以后,它还值不值得保留?
这五个问题直接产出四件事:failure analysis(假设被违反的 data regime 就是可预测的失败模式)、ablation 设计(消融偏置本身,而不是随机拆模块)、regime 分析(方法 X 该在什么数据上赢、为什么)、研究问题发现(哪些假设还没被审计——非平稳性刚被 TimeBridge 审计完,下一个轮到谁)。
风险:这个框架骗你的六种方式
- 偏置错了:真实数据不满足假设,系统性误差,数据再多也救不回来。
- 偏置太强:小数据时样本效率高,但把正确的解排除在可达范围外,形成天花板。
- 偏置太弱:假设空间理论上够大,有限数据和算力根本学不出来——vanilla Transformer 在 LTSF 上输给 DLinear 就是这一面的注脚。
- 把 benchmark 特性误当领域规律:ETT 上 channel independence 有效,不代表时序天然应该通道独立,可能只是那个数据集的跨变量信号弱。
- 事后解释:模块先涨点,再倒推“因为这个归纳偏置合理”。没有针对假设本身的 stress test 和失败场景,这就不是机制证据。
- 与优化、算力混淆:提升可能来自更好的归一化、更久的训练、更多的参数,而不是你的结构假设对了。$\text{更好的偏置} \neq \text{更好的优化} \neq \text{更多的算力}$。
延伸:RL 和 Agent 里同一套逻辑
RL 和 Agent 并没有脱离统计学习,只是偏置的位置从函数空间扩展到了计算过程。RL 的偏置藏在状态表示、动力学假设(Markov 与否)、奖励设计、探索策略、planning 方式里;Agent 的偏置藏在记忆、检索、工具使用、层级分解、verifier,以及 ReAct 这类 reason → action → feedback 循环里。同样是试十次:随机重试十次,错误彼此独立,第十次的解和第一次的没有本质区别;ReAct 每次失败都带着环境反馈,把可行解空间切掉一块,第十次拿到的解和第一次的完全是两回事。押注的对象因此从“某个函数”挪到了“解决问题的过程”上,可以称之为计算过程中的归纳偏置。
收束
整条逻辑可以压缩成:真实世界未知 → 有限数据不能唯一决定答案 → 必须系统性偏好某些解 → 模型设计史就是编码偏置的历史 → scaling 是偏置的自然选择。而方法研究做的事也一直是同一件:发现问题结构 → 提出假设 → 把假设编码成偏置 → 设计模型 → 验证适用范围和失败边界。
科研里最危险的不是有 bias,而是你不知道自己加了什么 bias,也不知道它在哪个 regime 下会失效。